
終於來到最後一天,這位新同事已經掌握了探索產品潛在問題的技巧,能夠判斷問題真偽並自行開票,甚至開始著手修改自動化測試案例的程式碼,並自動修復測試程式碼問題。終於,我們今天要使用 /duty-oncall 將一切串連起來,不再需要人為介入每個階段,並且針對這 30 天鐵人賽收尾。
/duty-oncall 簡單來說就是組合連續技,將前面討論過的 bug-hunter 尋找問題、bug-verifier 獨立驗證、issue-quality-gate 是不是真的要開票出來、使用 triage 將問題分類,最後 bug-fixer 修復簡單的問題,串連起來,讓新同事自己能夠獨立處理,最後只需要留下證據與結果,讓我們 審閱就好。
這一次使用的測試範圍就是前幾天的定義好的 charters/toolshop-login-cart.yaml - 針對登入頁面、商品頁面、購物車、註冊、付款、結帳表單等等做非破壞性的探索 Bug,當然如果你還沒有這份探索章程,也可以使用 /exploration-charter skill 建立需要的探索章程(charter)。
charter:
  goal: "在 Bug Hunting build(with-bugs.practicesoftwaretesting.com)獵一輪 bug,含註冊/付款/API/安全類(非破壞性)"
  target: "https://with-bugs.practicesoftwaretesting.com/#/?bug-hunting=true"
  scope: [登入頁, 商品頁, 購物車, 註冊, 付款, 結帳表單, 個人資料, 聯絡表單]
  tours: [authz]
....
因為怕新同事可能會合併變更或是重置環境裡面的設定,我們之前撰寫的 governance.example.yaml 的授權分級總表也會繼續沿用。
tiers:
  autonomous: []
  needs_review: []
  forbidden:
    - merge_pr
    - reset_shared_env
    - truncate_shared_db
override:
  require_reason: true
準備好了,我們就在 sdet-skills/ 開啟對話。你可以直接貼上下面這段:
/duty-oncall 用 charters/toolshop-login-cart.yaml 執行一輪值班。
沿用目前專案的範圍、預算與授權分級表,依序探索、重驗、檢查,再分類問題。
開票、修改程式、與建立合併請求都需要由我來同意;沒有獲得授權就附上證據與紀錄。
從開始就記錄各個階段的 token 用量,如果達到預算上限就停止。
最後請給我一份能夠 5 分鐘看完的摘要,裡面記錄:
1. 完成了哪些事情
2. 有哪些事情被中斷
3. 我需要幫忙處理哪些東西
記得如果有修 bug 的時候,不要自己合併,也不要修改授權分析的清單。
如果你希望把檔案放在某個特定的資料夾下,可以補充下面的內容,但預設的路徑應該有在 skill 裡面定義清楚。
專案:toolshop
輪次:20260928_toolshop-oncall
本輪目錄:output/sessions/20260928_toolshop-oncall/
開單檢查:output/sessions/20260928_toolshop-oncall/gate.yaml
值班紀錄:output/sessions/20260928_toolshop-oncall/runs/2026-09-28.yaml
送出後,這位新同事就會照這段提示,依序跑完探索、重驗、檢查與分類,最後交回一份五分鐘看得完的摘要。下面這張,就是它實際跑完一輪後交回的樣子:
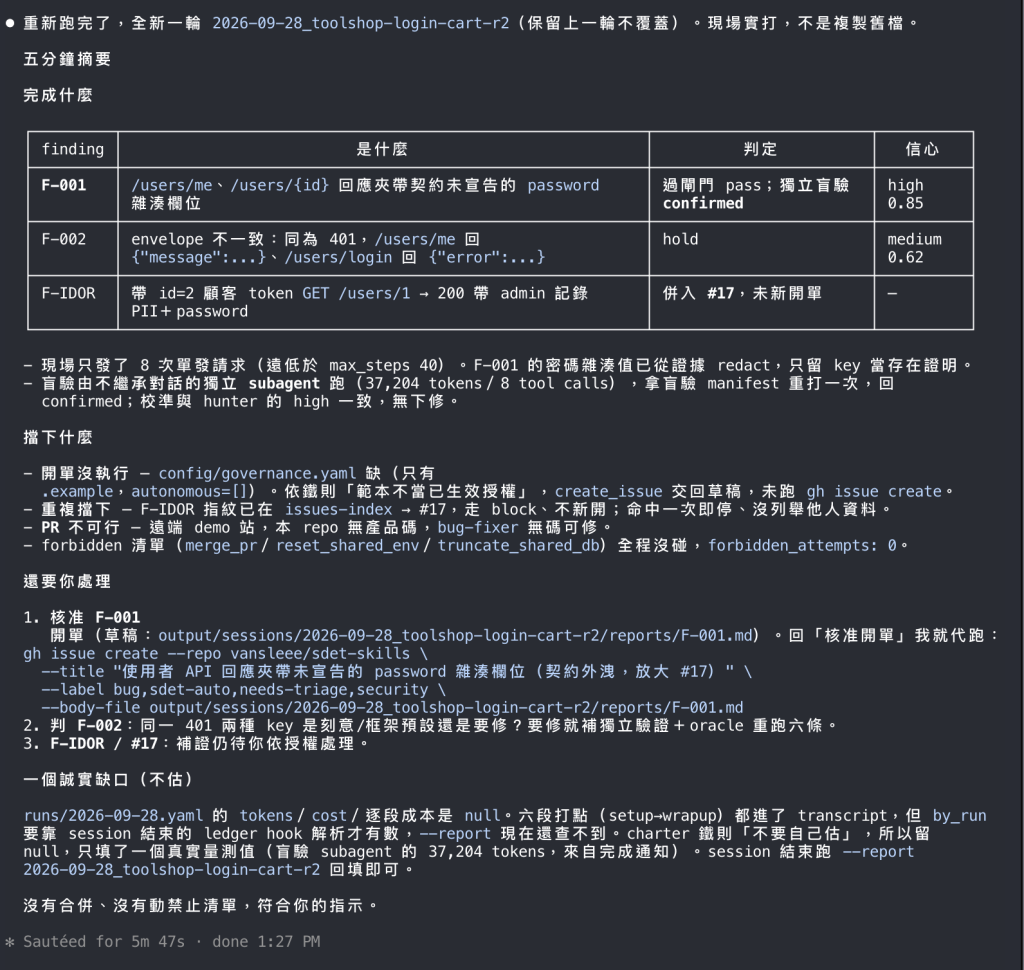
摘要分三段對齊提示詞的要求:完成什麼、擋下什麼、還要你處理什麼。開單需要授權時交回草稿而非自行執行,成本拿不到的那段誠實留白、不估算。
輸出結果在 output/sessions/2026-09-28_toolshop-login-cart-r3/runs/2026-09-28.yaml:
date: 2026-09-28
session: 2026-09-28_toolshop-login-cart-r3
charter: charters/toolshop-login-cart.yaml
tokens: null                    # by_run 由 session 結束的 ledger hook 解析 transcript 才有;不編造
cost_usd: null                  # 同上,收班跑 token-ledger.py --report 回填
measured:                       # 唯一可靠的即時量測值,來自 subagent 結束的完成通知
  verify_subagent_tokens: 36132
findings: 2                     # 候選 F-001(high)+ F-002(medium,未達門檻留人判)
gate_passed: 1                  # F-001
issues_opened: 1                # #21 — 這輪把 create_issue 放進 autonomous,值班自動開單
issues_opened_urls: [https://github.com/vansleee/sdet-skills/issues/21]
prs_opened: 0                   # 遠端 demo 站無產品碼可修
held_for_human: 1               # F-002(hold);F-IDOR 重複 #17 擋下未新開
forbidden_attempts: 0
confirmed_by_human: null        # 待回填(只能由你逐筆覆核 #21 後填)
這 30 天新同事主要學到兩件事情:第一件事情:其實是怎麼去尋找 Bug,第二件事情:是怎麼撰寫與維護測試案例。當我們把測試整合到 CI 之後,它要怎麼知道這些問題的分類?甚至有一些測試案例是 flaky test,那新同事怎麼去衡量這件事情?
第一週的時候,把環境建立好,並且讓 Claude 知道怎麼照著我們的流程,甚至知道我們想要測試的產品的樣貌,最後它可以跑一次完整的 end-to-end 測試。
第二週的時候,我們希望它可以像一個 QA 一樣去探索產品的問題。但有時候它找到的問題,可能不如我們預期真的是產品的 bug,所以我們必須要教它:如果找到問題,該怎麼把證據留下來、如何以結構化的方式回報,甚至讓我們可以判斷出哪些問題比較重要、哪些比較不重要,並且寫出一份我們看得懂的 Bug Report,這樣我們才能知道哪些 bug 才是我們需要修的。
第三週我們就真的讓它自主去探索產品的 bug,並且我們必須要告訴它什麼東西是真的問題。
當然有些東西可能不需要解釋,就可以很直覺地判斷;但有些可能涉及到產品的規格或一些 domain knowledge。我們可以透過進行分類,甚至為了避免 false positive,我們還會把過去出現過的 Bug 從清單上面刪掉,並且重新再盲驗一次,確定這個 bug 真的可以重現,才會把它開成票。
最後一週,我們試著讓它可以寫自動化測試,並且自己去修復,甚至去找出哪些是真正不穩定(flaky)的測試。
最後一天,我們把前面第二週跟第三週的內容串聯起來,讓它可以自主探索問題、驗證問題,最後去開 Bug Report。
當初其實是因為工作太忙,所以希望能夠透過 AI 來幫我處理大部分日常的測試任務,也希望它能夠自主完成這些事情,只有在需要的時候提出問題。
因此,跟 AI 討論後延展出了這些 skills。但有些 sills 其實太過於細節和繁複,因為隨著 model 越來越聰明,我們要去提示、交代它的事情其實是越來越少。或許將來某些 skills 是可以合併在一起,在這一系列中,我慢慢真的能夠體會到我們可以使用 AI 去探索產品 bug,甚至它可以幫我們修一些自動化測試。但最後的問題還是需要審查這些問題是不是真的 Bug,但隨著不斷的調整,最終你可以越來越信任這個流程。
雖然我知道 AI 能夠協助更大的範圍,但我希望這一系列可以給那些因測試工作而想使用 AI 的人一些啟發,去看看它怎麼幫你自動完成工作上較複雜的任務,並且讓它符合你可能產出的成果,進而提升品質。當然,由於是與 AI 協同建立的設定跟 skills,因為由 AI 來修改和建立,在描述甚至內容上其實還是蠻 AI 的口吻。但隨著時間慢慢改進、不斷去修正它,讓它會慢慢貼近你的語氣和工作流程,它最後真的會成為你的職務代理人。


 iThome鐵人賽
 看影片追技術